실험 기간을 좀 더 늘리면 안 돼요?
실험을 한 번 진행했는데 통계적으로 유의하지 못한 결과를 얻었습니다. 기간을 조금 더 두고 실험을 하자니 시간이 오래 걸릴 것 같은데 기존 결과를 그대로 포함해서 실험 기간을 늘려서 보면 안 되나요?

생키 다이어그램 (Sankey Diagram) 은 흐름(Flow) 다이어그램의 한 종류로써 그 화살표의 너비로 흐름의 양을 비율적으로 보여준다.
생키 다이어그램은 한 시스템 내에서 주요한 이동이나 흐름을 강조할 수 있다. 이를 이용하면 어떤 것이 흐름에서 가장 중요한 부분을 차지하는지 알 수 있다. 때로는 정의된 시스템의 범위 안에서 보존된 수량을 보여주기도 한다.
라고 위키에 적혀 있더라고요
사용자에 대한 분석을 진행하다가 한 사용자 그룹에서 그 숫자가 꽤 많이 줄어든 것을 발견했습니다. 그래서 그 사람들은 어디로 갔을까 그 많던 싱하는 어디로 갔을까 를 찾기 위해 생키 다이어그램을 이용해봤습니다.
예전 회사에서 옆사람을 괴롭혀서 파이썬으로 이 차트를 그리게 한 적은 있지만 직접 그리는 적은 처음이었어요. 지금 회사에서는 주로 R을 사용하고 있어서 이번에는 파이썬이 아니라 R 을 이용했습니다.
당연히 회사에서 사용한 데이터를 그대로 보여줄 수는 없으니 여기서는 만들어낸 가공의 데이터를 사용하겠지만 그 과정이나 코드는 동일합니다. 나는 매월 초 각 그룹에 있던 사용자들이 다른 그룹으로 얼마나 옮겨가고 있는지를 보고자 했고요. 아래의 예에서는 1월부터 4월까지 각 그룹의 사용자들이 어떻게 바뀌는지를 살펴시죠.
데이터 베이스 내에는 아래와 같은 형식으로 쌓여 있다면 금상첨화겠지만 아닌 경우에는… 적당히 알아서 잘 가공을 하시면 됩니다. 화이팅!!
| userid | group | date |
|---|---|---|
| 1 | Group A | 2019-01-01 |
| 2 | Group B | 2019-01-01 |
| 1 | Group B | 2019-02-01 |
| 2 | Group C | 2019-02-01 |
| 1 | Group A | 2019-03-01 |
| 2 | Group B | 2019-03-01 |
| 1 | Group C | 2019-04-01 |
| 2 | Group B | 2019-04-01 |
| … | … | … |
여기서는 userid 가 1과 2 두 명에 대해서 예를 들었는데 실제는 당연히 이보다 훨씬 더 많은 게 당연하니 요금 폭탄이 싫으시면 연산량은 적당히 알아서 잘 조절하시고, 휴식이 필요하신 분은 대충 돌리신 다음 좀 쉬고 오세요.
R 의 networkD3 패키지의 sankeyNetwork 에서는 위의 데이터가 source, target, value 라는 세 개의 컬럼만 가지도록 바뀌어야 합니다. 여기서 source 는 시작하는 그룹, target 은 바뀐 그룹을 의미하고, value 는 몇 명이나 이동했는지를 의미합니다.
물론 이러한 처리는 애초에 데이터를 땡겨올 때 SQL 로 처리를 해도 무방하지만 저는 관련 내용으로 다른 분석을 미리 R 로 진행하고 있었기 때문에 전처리도 그냥 R 에서 했습니다. 제가 가지고 왔던 데이터셋의 모양은 아래와 같았고요.
일단은 userid 기준으로 각 기간에서의 그룹을 아래와 같이 변환한 상태로 DB 에서 데이터를 땡겨왔어요. 물론 이걸로는 부족했죠.
| userid | jan_group | feb_group | mar_group | apr_group |
|---|---|---|---|---|
| 1 | Group A | Group B | Group A | Group C |
| 2 | Group B | Group C | Group B | Group B |
| … | … | … | … | … |
위의 데이터에서 부족했던 부분은 networkD3 의 sankeyNetwork 함수에서 에서 요구하는 데이터셋으로 만들 때에 발생했었어요. 위에서 언급했듯이 networkD3 의 sankeyNetwork 함수는 source, target, value 의 세 가지 컬럼으로 이루어져야 하는데 이렇게 만들어 버리면 Group A, Group B, Group C 만으로는 이게 1월의 값인지 2월의 값인지를 구분을 할 수 없기 때문에 요상한 그림이 나옵니다. 어… 분명히 나왔는데 어떻게 했더라…
그래서 이 그룹이 어느 시점의 그룹인지 알아먹을 수 있도록 구분자를 넣어줍시다. 그리고 value 는 한 그룹에서 다른 그룹으로 이동한 사용자의 숫자로 나타내기로 하겠습니다. 변환에 사용한 R 코드는 아래와 같습니다.
links <-
  df %>%
  mutate(jan_membership = paste('Jan', jan_membership),
         feb_membership = paste('Feb', feb_membership)) %>%
  group_by(source = jan_membership, target = feb_membership) %>%
  summarise(value = n()) %>%
  union(df %>% mutate(feb_membership = paste('Feb', feb_membership),
                      mar_membership = paste('Mar', mar_membership)) %>%
           group_by(source = feb_membership, target = mar_membership) %>% summarise(value = n())) %>%
  union(df %>% mutate(mar_membership = paste('Mar', mar_membership),
                      apr_membership = paste('Apr', apr_membership)) %>%
          group_by(source = mar_membership, target = apr_membership) %>% summarise(value = n())) %>%
  as.data.frame()
코드는 효율적이지 않을 수도 있고 보다 나은 방법이 있을 수도 있으니 알아서 잘 하시면 됩니다. 여튼 데이터 셋은 아래와 같이 변환하면 됩니다. 물론 컬럼명도 달라도 되지만 sankeyNetwork 에서 사용하는 arguments 랑 비슷한 게 덜 헷갈리고 좋지 않을까 싶네요.
마지막에 as.data.frame 을 넣은 부분은 dplyr 의 파이프라인(%>%) 을 타면 클래스가 온전한 data.frame 이 아니라 tbl(tibble) 이 되기 때문에 sankeyNetwork 에서 경고 메시지가 뜨는데 이게 보기 싫어서 넣은 부분이라 무시하셔도 됩니다.
| source | target | value |
|---|---|---|
| Jan Group A | Feb Group A | 94 |
| Jan Group A | Feb Group B | 125 |
| … | … | … |
| Jan Group B | Feb Group C | 96 |
| … | … | … |
생키 다이어그램을 그리는 부분은 the R Graph Gallery 를 참고했어요.
각 단계에서 사용할 노드의 이름을 정해줘야 합니다. 예제의 데이터셋에서는 각 월 Jan, Feb, Mar, Apr 별로 Group A, Group B, Group C 총 12개의 노드가 존재하는데요. 주의해야 할 점은 각각의 노드가 특정 시점을 기준으로 한다는 것입니다. 즉, 처음 시작은 Jan Group A, Jan Group B, Jan Group C 세 개라는 것이죠. 위의 the R Graph Gallery 에서는 시점에 따른 변화가 아니기 때문에 이를 수정할 필요가 있었습니다.
nodes <- data.frame(
    name = c('Jan Group A', 'Jan Group B', 'Jan Group C',
             unique(as.character(links$target)))
)
열심히 이름으로 바꿔놨더니 이름을 안 쓰네요… 어쩌겠어요 시키는대로 바꿔야죠. 대부분의 프로그래밍 언어는 1이 아니라 0부터 시작합니다. 그래서 R 은 프로그래밍 언어가 아니라고 하시는 분들도 계시고요
여기서 사용하는 networkD3 패키지도 이름에서 알 수 있겠지만 뭔가 JavaScript 에서 쓰는 D3.js 같은 느낌이 나지 않습니까? 네, 주의사항에도 나오겠지만 여기서도 0부터 시작해야 합니다(Zero index 라고 하더군요).
아래와 같이 match 함수를 이용해서 source 와 target 컬럼의 값들을 숫자로 바꿔주고 1을 빼서 0부터 시작하게 만들어 줍니다.
links$IDsource <- match(links$source, nodes$name) - 1
links$IDtarget <- match(links$target, nodes$name) - 1
그리는 건 오히려 어렵지 않습니다. 컬럼명을 argument 와 비슷하게 만들어 놨기 때문에 argument 에 맞게끔 컬럼명을 넣어 주시면 됩니다. 여기서는 value 컬럼의 값이 한 그룹에서 다른 그룹으로 이동한 사용자의 숫자 이기 때문에 단위를 ‘명’ 과 비슷한 ‘people’ 로 했습니다.
그냥 바로 그려도 되는데 별도의 변수에 저장하면 나중에 saveNetwork 함수를 이용해서 html 형태로 내보내기 쉬워집니다.
p <- sankeyNetwork(Links = links, Nodes = nodes,
                   Source = "IDsource", Target = "IDtarget",
                   Value = "value", NodeID = "name",
                   sinksRight = FALSE, units = 'people')
p
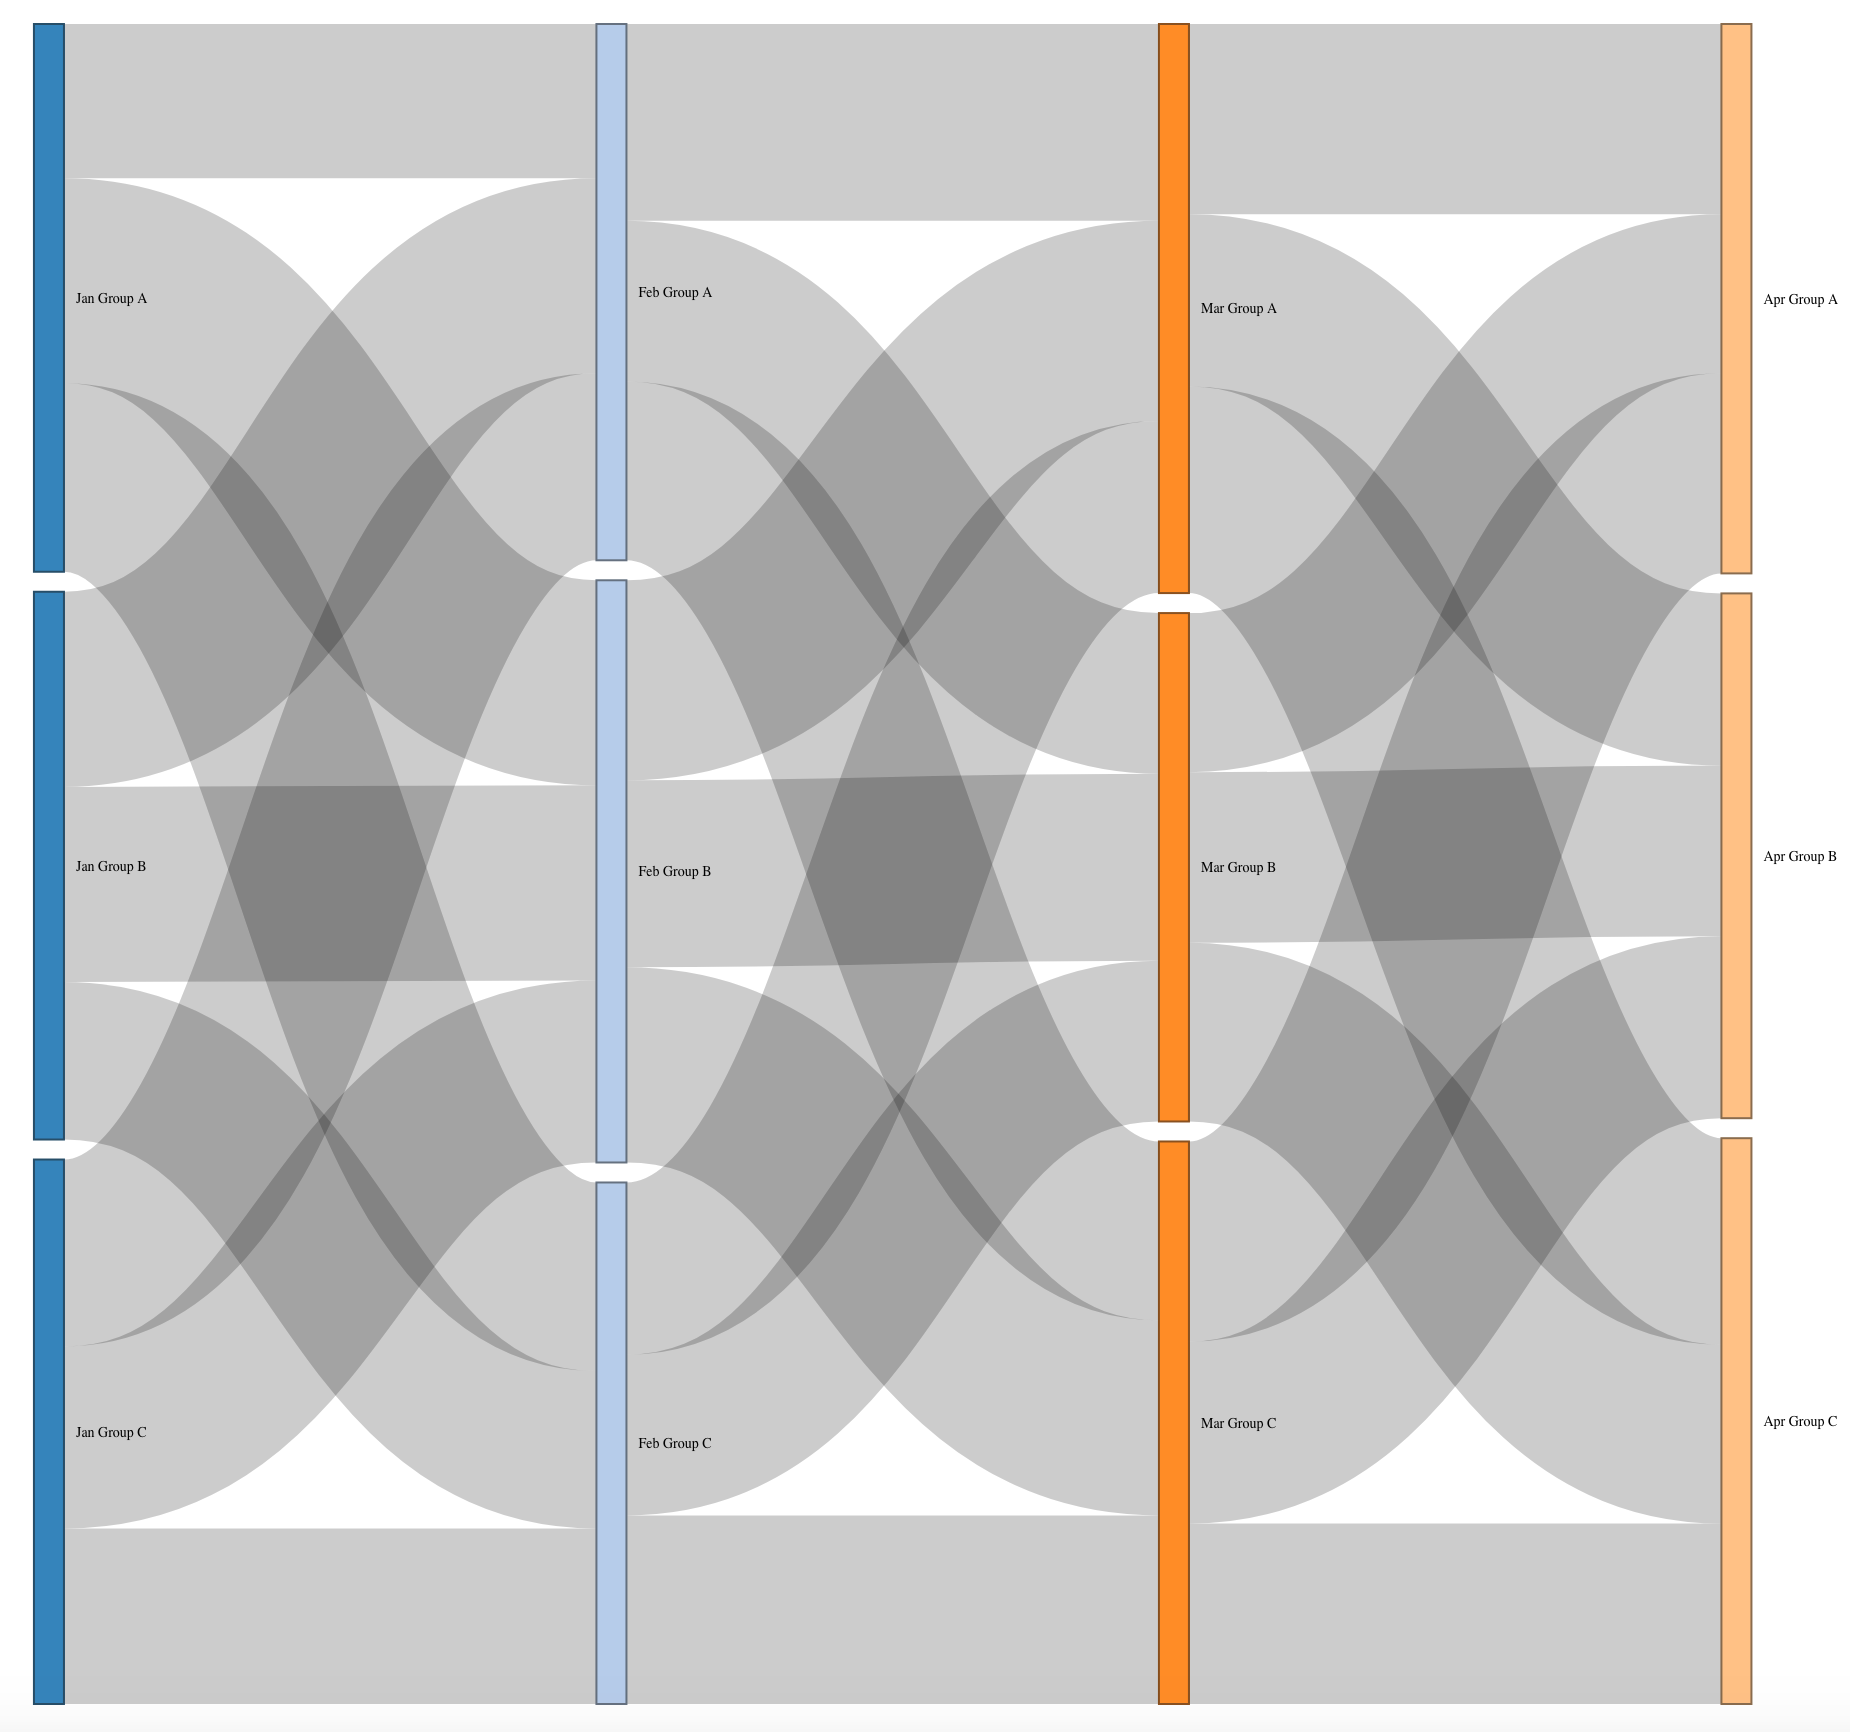
html 형태로 보시면 해당 흐름 위에 커서를 올리면 값이 보이는데 html 파일을 올리는 방법을 모르겠네요… 찾아보고 수정하겠습니다. 안 될 수도 있고요.
고생하셨습니다. 여러분이 그리신 생키 다이어그램을 보시면서 뿌듯해하시면 됩니다.
실험을 한 번 진행했는데 통계적으로 유의하지 못한 결과를 얻었습니다. 기간을 조금 더 두고 실험을 하자니 시간이 오래 걸릴 것 같은데 기존 결과를 그대로 포함해서 실험 기간을 늘려서 보면 안 되나요?
A/B 테스트란 무엇이고, 제가 왜 이게 통계학을 망치고 있다고 생각하는지 설명드리고자 합니다.
이 글은 AI가 데이터베이스에 직접 접근해 인간 전문가처럼 데이터를 분석하는 새로운 워크플로우를 소개합니다. 단순한 질의응답을 뛰어넘는 이러한 도약은 데이터 분석가의 역할이 근본적으로 재정의될 미래를 암시합니다.
이 글은 넷플릭스 (Netflix) 에서의 분석 엔지니어링 (Analytics Engineering) 관련 업무의 범위를 공유하기 위한 여러 편의 글 중 두 번째 글이며, 최근에 열렸던 분석 엔지니어링 컨퍼런스에서 발표된 내용이기도 합니다. 더 많은 내용이 궁금하신가요? 첫 번째 ...
듀오링고의 350% 성장의 뒷 이야기, 리더보드, 연속 학습, 알림, 그리고 혁신적인 그로스 모델 들어가기에 앞서
듀오링고의 350% 성장의 뒷 이야기, 리더보드, 연속 학습, 알림, 그리고 혁신적인 그로스 모델 들어가기에 앞서
듀오링고의 350% 성장의 뒷 이야기, 리더보드, 연속 학습, 알림, 그리고 혁신적인 그로스 모델
원문: Meaningful metrics: How data sharpened the focus of product teams
원문: Sequential Testing at Booking.com
가장 좋은 방법은 당연히 영어 밖에 사용하지 못하는 환경에 강제로 처해지는 것이겠지만 그것이 어려우니…
고민의 흔적을 보여주세요
을 찾습니다.
원문: Charts & Accessibility
모수, 큰 수의 법칙, 그리고 중심극한정리에 대하여
그리고 여러분들도 (아마도) 하지 않아야 하는 이유
회사 서비스의 추천 시스템을 개선하기 위해 팀 내에서 (아직까진 두 명이긴 하지만) 지난 두 달 동안 스터디를 진행했습니다. 얼마 전 두 번째 스터디가 끝났고 이에 대한 회고를 해보려고 합니다.
원문: Dark Side of Data: Privacy by Emre Rencberoglu
원문: RStudio Projects and Working Directories: A Beginner’s Guide by Martin Chan
원문: TidyTuesday GitHub Repository
원문: How programming languages got their names
원문: How to Make Meetings Less Terrible 팟캐스트: How to Make Meetings Less Terrible (Ep. 389)
생키 다이어그램 (Sankey Diagram) 은 흐름(Flow) 다이어그램의 한 종류로써 그 화살표의 너비로 흐름의 양을 비율적으로 보여준다.
2년 전 일본어로 책을 내긴 했지만 대부분의 독자들이 이 책을 읽을 수는 없을 것 같았다.
자기회귀 모형이란 무엇인가?
회귀분석을 실행하기 위해 필요한 가정과 조건들에 대해 알아보자.
통계적 검정과 회귀분석에서 자주 사용되는 정규성 가정과 정규성 검정에 대해 알아보자.
여러 통계 검정과 모형에서 사용되는 독립성 가정에 대해 알아보자.
시계열 모형 중 ARMA 모형에대해 알아보자.
시각화에서 주의할 점인 넓이를 표시하는 원칙에 대해 알아보자.
평균 양쪽의 z-값들 사이의 넓이를 구하는 방법에 대해 알아보자.
분산분석의 개념과 방법에 대해 알아보자.
분산분석(ANOVA; ANalysis Of VAriance) 와 회귀분석의 개념을 섞은 공분산분석(ANCOVA; ANalysis of COVAriance)에 대해 알아보자. 이 글을 이해하기 위해서는 아래의 글을 먼저 읽는 것이 좋다.
Akaike’s Information Criterion 의 정의와 이를 구하는 방법에 대해 알아보자.
수정된 R제곱과 그 용도에 대해서 알아보자.
통계 용어 중 정확도(Accuracy)와 정밀도(Precision) 에 대해서 알아보자.
절대 오차와 평균 절대 오차에 대해서 알아보자.
가설 검정이란 무엇이며, 가설 검정의 다양한 방법에 대해 알아보자.
회귀분석이란 무엇이며, 회귀분석 과정에서 사용하는 용어와 다양한 방법에 대해 알아보자.
이 글은 MathJax 를 GitHub Pages Jekyll blog 에 추가하는 방법을 다룬다. 이탤릭체로 된 부분은 본문에는 없고 제가 따라하면서 고치거나 추가한 부분이니 참고하세요.
모집단과 표본집단을 이용하는 경우 통계학에서 말하는 10% 조건이 무엇인지에 대해 알아보자.
여러분의 GitHub 블로그에 Jupyter notebook 을 바꿔서 올릴 수 있도록 도와줄 글입니다. 직접 바꾸는 방법은 1회성 글들을 위해서 추가했고, 변환 과정과 파일 이동, 그리고 여러분의 블로그에 올리는 것까지 한 번에 할 수 있는 자동화 bash 를 만드는 자세한 방법...
68 95 99.7의 법칙이란 무엇인가?
단위근 검정 방법 중 하나인 Augmented Dickey Fuller 검정에 대해 알아보자.
이 자료는 데이터 과학과 관련된 특정 주제에 대한 연재물이며, 다룰 주제는 다음과 같다. 회귀분석, 군집화, 신경망, 딥러닝, 의사결정나무, 앙상블, 상관관계, 파이썬, R, 텐서플로우, SVM, 데이터 축소, 피쳐 선택, 실험 계획법, 교차검증, 모델 피팅 등. 이 글을 계속 받...